목차
『가상 면접 사례로 배우는 대규모 시스템 설계 기초 2』를 읽으며 정리하는 시리즈의 두 번째 글입니다.
2장은 주변 친구(Nearby Friends), 즉 위치 공유를 허용한 친구 가운데 가까이 있는 친구를 찾아 보여 주는 기능을 설계합니다.
1단계: 문제 이해 및 설계 범위 확정
면접에서 던지는 질문
- 얼마나 가까워야 '주변'인가? (예: 5마일)
- 거리는 두 사용자 사이의 직선거리로 계산하는가?
- 사용자는 몇 명인가?
- 사용자의 위치 이동 이력을 보관해야 하는가?
- 친구가 일정 시간 이상 활동하지 않으면 목록에서 빼는가? 그 시간은 얼마인가?
- GDPR·CCPA 같은 개인정보 보호법을 고려해야 하는가?
GDPR·CCPA
GDPR(General Data Protection Regulation)은 EU의 개인정보 보호법이고, CCPA(California Consumer Privacy Act)는 미국 캘리포니아주의 소비자 개인정보 보호법입니다.
위치는 민감한 개인정보라서, 이런 법을 따라야 하는지를 범위를 정할 때 확인합니다.
기능 요구사항
- 모바일 앱에서 주변 친구 목록을 볼 수 있다.
- 목록의 각 친구에는 나와의 거리와, 그 거리가 마지막으로 갱신된 시각이 표시된다.
- 친구 목록은 일정한 간격으로 갱신된다.
비기능 요구사항
- 낮은 지연(low latency): 친구의 위치 변화가 빠르게 반영되어야 한다.
- 안정성: 시스템은 전반적으로 안정적이어야 하지만, 몇몇 위치 데이터를 잃는 것은 허용한다.
- 결과적 일관성(eventual consistency): 복제본의 데이터가 원본과 같아지기까지 몇 초 정도 걸리는 것은 허용한다.
개략적 규모 추정
| 항목 | 값 |
|---|---|
| 주변 친구의 기준 | 반경 5마일(약 8km) 이내 |
| 위치 갱신 주기 | 30초 |
| 일간 능동 사용자(DAU) | 1억 명 |
| 동시 접속 사용자 | DAU의 10% = 1,000만 명 |
| 사용자 1명의 평균 친구 수 | 400명 (모두 주변 친구 기능을 사용) |
| 한 페이지에 보여 주는 주변 친구 | 20명 (요청하면 더 보여 줌) |
| 위치 갱신 QPS | 1,000만 ÷ 30초 ≈ 334,000 |
왜 30초마다 갱신할까
사람이 걷는 속도는 시간당 3~4마일(약 5~6km)입니다.
30초 동안 움직이는 거리는 50m 정도라서, 30초마다 갱신해도 주변 친구 검색 결과는 크게 달라지지 않습니다.
2단계: 개략적 설계안 제시 및 동의 구하기
이 기능은 한 사용자의 위치가 바뀌면 그 변화를 친구들에게 서버가 먼저 보내야(push) 합니다.
그래서 클라이언트와 서버 사이의 통신 프로토콜로 단순한 HTTP를 쓰기 어려울 수 있다는 점을 염두에 두고 설계합니다.
서버가 먼저 보내는 통신(push)
HTTP는 클라이언트가 요청해야 서버가 응답하는 방식이라, 서버가 원하는 때에 데이터를 보낼 수 없습니다.
클라이언트가 주기적으로 물어보게(폴링) 하면 바뀐 게 없어도 요청이 계속 오고, 변화도 늦게 전달됩니다.
그래서 이 설계에서는 연결을 한 번 맺은 뒤 서버와 클라이언트가 언제든 서로 메시지를 보낼 수 있는 웹소켓(WebSocket)을 씁니다.
개략적 설계
이론적으로는 순수한 P2P(peer-to-peer) 방식으로도 풀 수 있습니다.
활성 상태인 친구끼리 직접 연결을 유지하고, 위치가 바뀔 때마다 서로에게 전달하는 방식입니다.
하지만 모바일 단말은 통신 연결 상태가 좋지 않을 때가 있고 전력도 아껴야 해서, 실용적인 방법은 아닙니다.
그래도 설계 방향에 대한 통찰을 얻기에는 충분합니다.
더 실용적인 설계안은 공용 백엔드를 두는 것입니다.
백엔드 서버가 하는 일은 다음과 같습니다.
- 모든 활성 사용자의 위치 변화를 받는다.
- 위치 변화를 받을 때마다 그 사용자의 활성 친구를 모두 찾아, 친구들의 단말로 변경 내역을 전송한다.
- 두 사용자 사이의 거리가 임계치보다 멀면 전송하지 않는다.
설계만 보면 간단하지만, 규모가 커지면 그대로 적용하기 어렵습니다.
앞에서 계산한 대로 위치 갱신은 초당 334,000건입니다.
사용자 1명의 친구가 평균 400명이고 그중 10%가 주변에서 활성 상태라고 하면, 초당 334,000 × 400 × 10% ≈ 1,400만 건의 위치 변경을 처리해 친구들의 단말로 보내야 합니다.
로드밸런서
RESTful API 서버와 유상태(stateful) 웹소켓 서버 앞에 위치합니다.
트래픽을 여러 서버에 나눠 부하를 분산합니다.
RESTful API 서버
무상태(stateless) API 서버의 클러스터로, 일반적인 요청/응답 트래픽을 처리합니다.
친구 추가·삭제나 사용자 정보 갱신 같은 부가적인 기능을 맡습니다.
웹소켓 서버
친구의 위치 변경을 실시간에 가깝게 처리하는 유상태 서버 클러스터입니다.
각 클라이언트는 이 가운데 한 대와 웹소켓 연결을 계속 유지합니다.
검색 반경 안에 있는 친구의 위치가 바뀌면 이 연결로 클라이언트에 전송합니다.
주변 친구 기능을 쓰는 클라이언트의 초기화도 웹소켓 서버가 담당합니다.
레디스 위치 정보 캐시
활성 사용자의 가장 최근 위치를 캐시합니다.
항목마다 TTL(Time-To-Live)을 두어, TTL이 지나도록 갱신되지 않은 사용자는 비활성 상태가 됩니다.
사용자 데이터베이스
사용자 정보와 친구 관계를 저장합니다.
위치 이동 이력 데이터베이스
사용자의 위치 변동 이력을 보관합니다.
레디스 pub/sub 서버
초경량 메시지 버스(message bus)로, 채널(토픽)을 수백만 개 만들 수 있습니다.
사용자마다 채널이 하나씩 있고, 그 사용자의 친구들과 연결된 웹소켓 핸들러는 모두 이 채널의 구독자로 설정되어 있습니다.
그래서 사용자의 위치가 바뀌면 친구들의 핸들러가 그 메시지를 받습니다.
- 사용자의 위치 변경 이벤트를 그 사용자에게 배정된 채널에 발행한다.
- 이벤트를 받은 각 핸들러는 자신과 연결된 친구가 활성 상태면 거리를 다시 계산한다.
- 새로 계산한 거리가 검색 반경 이내면, 갱신된 위치와 시각을 웹소켓 연결로 그 친구의 앱에 보낸다.
주기적 위치 갱신
- 모바일 클라이언트가 위치 변경을 로드밸런서에 보낸다.
- 로드밸런서가 변경 내역을 그 클라이언트와 연결된 웹소켓 서버로 전달한다.
- 웹소켓 서버가 위치 이동 이력을 DB에 저장한다.
- 새 위치를 위치 정보 캐시에 저장하고 TTL을 갱신한다.
이후 거리 계산에 쓰려고 웹소켓 연결 핸들러의 변수에도 저장한다. - 웹소켓 서버가 그 사용자의 레디스 pub/sub 채널에 새 위치를 발행한다.
- 레디스 pub/sub이 발행된 위치를 모든 구독자(친구들의 웹소켓 핸들러)에게 브로드캐스트(broadcast)한다.
- 메시지를 받은 웹소켓 서버는 발행자와 구독자 사이의 거리를 계산한다.
- 거리가 검색 반경 이내면, 새 위치와 이동이 발생한 시각(타임스탬프)을 구독자에게 보낸다.
- 로드밸런서를 거쳐 친구들의 앱에 전달된다.
3~5단계는 병렬로 실행합니다.
여러 사용자의 위치가 동시에 바뀔 때 채널 단위로 보면 다음과 같습니다.
- 사용자가 자신과 연결된 웹소켓 서버로 위치 변경 내역을 보낸다.
- 웹소켓 서버가 레디스 pub/sub의 그 사용자 전용 채널에 발행한다.
- 채널을 구독하는 모든 구독자(친구들의 웹소켓 연결)에게 브로드캐스트한다.
- 거리가 검색 반경 이내인 친구에게만 새 위치를 전송한다.
API 설계
친구 추가·삭제나 사용자 정보 갱신 같은 기본 HTTP API는 빼고, 웹소켓으로 주고받는 API만 정리합니다.
서버 API
| API | 요청 | 응답 |
|---|---|---|
| 주기적인 위치 정보 갱신 | 위도, 경도, 시각 | 없음 |
| 웹소켓 초기화 | 위도, 경도, 시각 | 친구들의 위치 데이터 |
클라이언트 API
| API | 요청 | 응답 |
|---|---|---|
| 갱신된 친구 위치 수신 | 친구의 위치 데이터와 시각(타임스탬프) | - |
| 새 친구 구독 | 웹소켓 서버가 친구 ID 전송 | 친구의 가장 최근 위도, 경도, 시각 |
| 구독 해지 | 웹소켓 서버가 친구 ID 전송 | 없음 |
데이터 모델
📌 위치 정보 캐시
| 키 | 값 |
|---|---|
| 사용자 ID | {위도, 경도, 시각} |
📌 위치 정보 저장에 DB를 쓰지 않는 이유
이 기능은 사용자의 '현재 위치'만 쓰기 때문에 사용자마다 위치를 하나만 저장하면 충분합니다.
레디스는 읽기·쓰기가 아주 빨라 이런 용도에 잘 맞습니다.
TTL을 지원해서 비활성 사용자를 자동으로 지울 수 있고, 주변 친구 기능의 위치 정보는 영속성을 보장할 필요도 없습니다.
레디스 서버에 장애가 나면 빈 서버로 교체하고, 다음 갱신 주기 동안 위치가 다시 채워질(warm-up) 때까지 기다려야 합니다.
그동안 일부 친구의 위치 변경을 놓칠 수 있지만, 수용 가능한 문제로 봅니다.
📌 위치 이동 이력 DB
| user_id | latitude | longitude | timestamp |
|---|
- 책에서는 쓰기 연산이 많고 수평적 확장이 쉬운 Apache Cassandra(NoSQL)가 잘 맞는다고 한다.
- RDB도 쓸 수 있지만, 이력 데이터가 서버 한 대에 담기에는 너무 많아서 사용자 ID 기준으로 샤딩(sharding)해야 한다.
3단계: 상세 설계
중요 구성요소별 규모 확장성
📌 API 서버
CPU 사용률, 부하, I/O 상태에 따라 클러스터 규모를 자동으로 늘리는 방법이 이미 많기 때문에 따로 다루지 않습니다.
📌 웹소켓 서버
API 서버처럼 자동으로 늘릴 수 있지만, 유상태 서버라서 기존 서버를 뺄 때 주의해야 합니다.
먼저 로드밸런서에서 그 서버의 상태를 '연결 종료 중(draining)'으로 바꿔 새 연결이 들어오지 않게 합니다.
기존 연결이 충분히 정리될 만큼 시간이 지난 뒤에 서버를 종료합니다.
유상태 서버 클러스터와 로드밸런서
유상태 서버 클러스터의 규모를 자동으로 조정하려면 이를 잘 받쳐 주는 로드밸런서가 필요합니다.
이때 조정은 확장과 축소를 모두 뜻합니다.
늘릴 때는 새 연결을 새 서버로 보내야 하고, 줄일 때는 위처럼 draining으로 기존 연결을 정리해야 하므로 두 방향 모두 로드밸런서의 도움이 필요합니다.
특히 축소는 연결이 끊긴 클라이언트가 다른 서버로 다시 연결해야 해서 더 조심스럽습니다.
📌 클라이언트 초기화
웹소켓 서버와 클라이언트는 지속성 연결(persistent connection)을 유지하지만, 오늘날 연결 하나를 유지하는 데 드는 메모리는 많지 않습니다.
웹소켓 연결이 초기화되면 클라이언트는 단말의 위치를 보내고, 웹소켓 서버는 그 위치로 다음 작업을 합니다.
sequenceDiagram
  participant C as 클라이언트
  participant W as 웹소켓 서버
  participant Cache as 위치 정보 캐시
  participant DB as 사용자 DB
  participant P as 레디스 pub/sub
  C->>W: 연결 + 현재 위치
  W->>Cache: 1. 내 위치 저장
  W->>W: 2. 연결 핸들러 변수에 저장
  W->>DB: 3. 친구 목록 조회
  W->>Cache: 4. 친구 위치 일괄 조회
  W->>C: 5. 반경 이내 친구의 정보·위치·시각
  W->>P: 6. 모든 친구의 채널 구독
  W->>P: 7. 내 채널에 현재 위치 발행
- 사용자의 위치를 위치 정보 캐시에 저장한다.
- 이후 거리 계산에 쓰려고 위치를 연결 핸들러의 변수에 저장한다.
- 사용자 DB에서 친구 목록을 가져온다.
- 위치 정보 캐시에 일괄(batch) 요청을 보내 모든 친구의 위치를 가져온다.
TTL이 있어서 비활성 친구는 캐시에 없다. - 사용자와 친구들 사이의 거리를 하나씩 계산해, 검색 반경 이내인 친구의 상세 정보와 위치, 시각을 클라이언트에 돌려준다.
- 각 친구의 레디스 pub/sub 채널을 구독한다.
- 채널은 만들고 구독하는 비용이 싸서, 모든 친구의 채널을 구독해도 괜찮다.
- 비활성 친구의 채널도 메모리를 조금 쓰지만, 친구가 활성 상태가 되기 전까지 CPU나 I/O를 쓰지 않으므로 무시한다.
- 레디스 pub/sub의 내 채널로 현재 위치를 보내 모든 친구에게 알린다.
연결 핸들러
연결 핸들러는 파일이 아니라, 웹소켓 서버 프로세스 안에서 연결 하나마다 만들어지는 처리 객체입니다.
연결이 맺어질 때 만들어지고 연결이 끊길 때 사라지며, 그 연결로 오가는 메시지를 처리합니다.
그래서 "핸들러의 변수에 저장한다"는 말은 그 연결의 메모리 상태로 사용자의 최근 위치를 들고 있다는 뜻입니다.
예를 들어 Spring의 웹소켓에서는 연결마다 생기는 세션(WebSocketSession)의 속성에 값을 담아 두는 것과 비슷합니다.
친구의 위치 변경 메시지를 받을 때마다 캐시를 다시 조회하지 않고, 메모리에 있는 내 위치로 바로 거리를 계산할 수 있습니다.
📌 사용자 DB
사용자 DB에는 두 가지 데이터를 저장합니다.
- 사용자 상세 정보(프로필)
- 친구 관계
이 시스템의 데이터 규모는 RDB 한 대로는 감당할 수 없어서, 사용자 ID 기준으로 샤딩해 수평적으로 확장해야 합니다.
실제로는 사용자·친구 데이터를 다른 팀이 관리하는 경우가 많아서, DB에 직접 질의하는 대신 내부 API로 가져옵니다.
그래도 시스템 성능에는 큰 차이가 없습니다.
📌 위치 정보 캐시
각 키에는 TTL을 두고, 사용자의 위치가 갱신될 때마다 TTL을 다시 설정합니다.
비활성 사용자는 자동으로 지워지므로 메모리 사용량이 일정 수준 아래로 유지됩니다.
가장 붐빌 때 1,000만 명이 활성 상태이고 한 사람의 위치에 100바이트가 필요하다고 하면, 1,000만 × 100바이트 = 약 1GB입니다.
메모리만 보면 레디스 한 대로 충분히 캐싱할 수 있습니다.
하지만 활성 사용자 모두가 30초마다 위치를 갱신하므로, 레디스 서버가 처리할 쓰기 연산은 초당 334,000건에 이릅니다.
서버 한 대가 감당하기에는 부담이 크므로, 사용자 ID 기준으로 샤딩해 여러 서버에 부하를 고르게 나눕니다.
가용성을 높이고 싶다면 각 샤드를 대기(standby) 노드에 복제해 두고, 주(primary) 노드에 장애가 나면 대기 노드를 주 노드로 승격해 장애 시간을 줄입니다.
📌 레디스 pub/sub
이 설계에서 pub/sub은 위치 변경 메시지를 친구들에게 보내는 라우팅(routing) 계층입니다.
- 주변 친구 기능을 쓰는 모든 사용자에게 채널을 하나씩 준다.
- 클라이언트를 초기화할 때 활성 상태와 상관없이 모든 친구의 채널을 구독한다.
친구가 비활성 상태가 될 때 구독을 끊고 다시 활성 상태가 될 때 구독하는 작업을 하지 않아서, 설계는 단순해지지만 메모리를 더 씁니다.
그래서 메모리가 병목이 될 수도 있을 것 같지만, 아래 계산을 보면 실제 병목은 CPU입니다.
레디스 pub/sub 서버는 몇 대 필요할까
📌 메모리 사용량
주변 친구 기능을 쓰는 모든 사용자에게 채널을 하나씩 주므로, 동시 접속자만이 아니라 DAU 전체인 1억 개의 채널이 생깁니다.
비활성 친구의 채널도 구독을 유지하기 때문입니다.
사용자 1명당 이 기능을 쓰는 친구가 평균 100명이고, 구독자 한 명을 추적하는 데 내부 해시 테이블과 연결 리스트의 포인터로 약 20바이트가 든다고 가정합니다.
1억 × 100 × 20바이트 = 200GB
메모리를 100GB까지 설치할 수 있는 서버라면 두 대로 모든 채널을 담을 수 있습니다.
구독자 한 명에 20바이트
책은 "약 20바이트"라고만 하고 근거는 따로 설명하지 않습니다.
64비트 환경에서 포인터는 8바이트라서, 연결 리스트 노드 하나(이전·다음·값 포인터 3개)만 해도 24바이트입니다.
실제 레디스는 채널별 구독자 목록 외에 클라이언트 쪽에도 구독 채널 목록을 따로 두기 때문에, 구독 하나에 드는 메모리는 이보다 큽니다.
20바이트는 정확한 값이 아니라 규모를 가늠하려는 어림값으로 보면 됩니다.
📌 CPU 사용량
pub/sub 서버가 구독자에게 보내야 하는 위치 갱신은 초당 약 1,400만 건입니다.
보수적으로 잡아 기가비트 네트워크를 갖춘 요즘 서버 한 대가 초당 100,000건을 구독자에게 보낼 수 있다고 가정합니다.
1,400만 ÷ 100,000 = 140대
보수적으로 잡은 값이라 실제로 필요한 서버는 훨씬 적을 것입니다.
| 기준 | 필요한 서버 |
|---|---|
| 메모리 (200GB ÷ 100GB) | 2대 |
| CPU (1,400만 ÷ 100,000) | 140대 |
- 레디스 pub/sub의 병목은 메모리가 아니라 CPU 사용량이다.
- 이 규모를 감당하려면 분산 레디스 pub/sub 클러스터가 필요하다.
분산 레디스 pub/sub 서버 클러스터
수백 대의 레디스 서버에 채널을 어떻게 나눠 담을까요?
채널끼리는 서로 독립적이므로, 메시지를 발행하는 사용자의 ID를 기준으로 pub/sub 서버들을 샤딩하면 됩니다.
- 가용한 서버 목록을 유지하고 그 목록을 갱신하는 기능이 필요하다.
책에서는 etcd나 ZooKeeper 같은 서비스 탐색(service discovery) 컴포넌트를 쓰는데, 여기서는 작은 키-값 저장소로 보고 진행한다.- 키:
/config/pub_sub_ring - 값:
["p_1", "p_2", "p_3", "p_4"]
- 키:
- 웹소켓 서버(클라이언트)는 이 해시 링 값의 변경 내역을 구독해, 서버 목록이 바뀌면 바로 알 수 있게 한다.
웹소켓 서버가 채널에 위치 변경 내역을 발행하는 과정은 다음과 같습니다.
- 웹소켓 서버는 해시 링을 참조해 메시지를 발행할 pub/sub 서버를 고른다.
효율을 높이려면 웹소켓 서버에 해시 링 사본을 캐싱할 수도 있다.
이때는 원본 해시 링과 사본이 계속 같도록 동기화해야 한다. - 고른 서버의 채널에 위치 정보를 발행한다.
레디스 pub/sub 서버 클러스터의 규모 확장 고려사항
- pub/sub 서버는 메시지를 구독자에게 보내고 나면 메모리나 디스크에 남기지 않으므로, 무상태 서버처럼 보인다.
- 하지만 채널별 구독자 목록이라는 상태를 들고 있다.
서버를 해시 링에서 빼면 그 서버의 채널은 다른 서버로 옮겨지고, 그 채널을 구독하던 구독자에게도 이 사실을 알려 다시 구독하게 해야 한다.
이런 관점에서 pub/sub 서버는 유상태 서버다.
유상태 서버 클러스터의 규모를 늘리거나 줄이는 것은 운영 부담과 위험이 큰 작업입니다.
- 클러스터를 조정하면 많은 채널이 해시 링의 다른 서버로 옮겨지고, 해시 링이 갱신되면서 재구독 요청이 한꺼번에 몰린다.
- 재구독 요청을 처리하는 동안 일부 위치 변경 메시지가 누락될 수 있다.
- 그래서 하루 중 시스템 부하가 가장 낮을 때 클러스터를 조정하는 게 좋다.
조정은 다음 순서로 진행합니다.
- 새로운 링 크기를 계산하고, 늘리는 경우라면 새 서버를 준비한다.
- 해시 링 키에 매달린 값을 새 서버 목록으로 갱신한다.
- 대시보드로 웹소켓 서버의 CPU 사용량 등을 모니터링한다.
마치며
책에는 내용이 더 있지만 읽는 것으로 만족했습니다.
운영 고려사항으로 장애가 난 노드를 대기 중인 노드로 교체하는 방법, 친구를 추가·삭제할 때 채널을 구독·해지하는 방법, 친구가 아주 많은 사용자를 다루는 방법이 나옵니다.
또 친구가 아닌 주변의 임의 사용자까지 보여 주려면 지오해시를 쓰는 방법도 있는데, 내용이 길어져서 이런 방법들이 있구나 하고 넘어갔습니다.
사실 공부하고 정리하는 것보다 스터디를 진행하는 게 더 힘든데, 특히 AI가 내 주는 문제를 푸는 게 더 힘듭니다.
QPS, CPU, 메모리 계산 같은 것들이 저는 쉽게 되지 않고, 업무와 너무 동떨어진 내용이라 여전히 읽고 이해하는 데 초점이 맞춰져 있습니다.
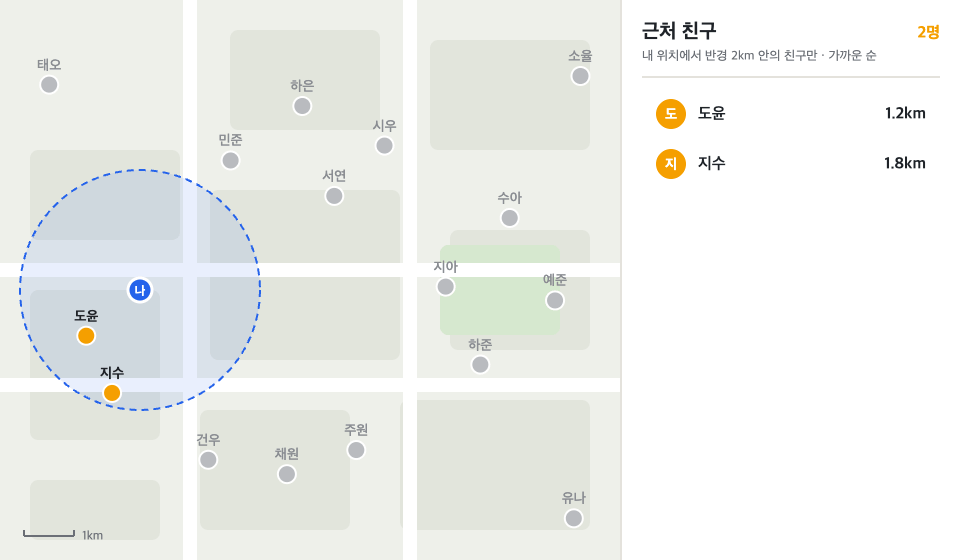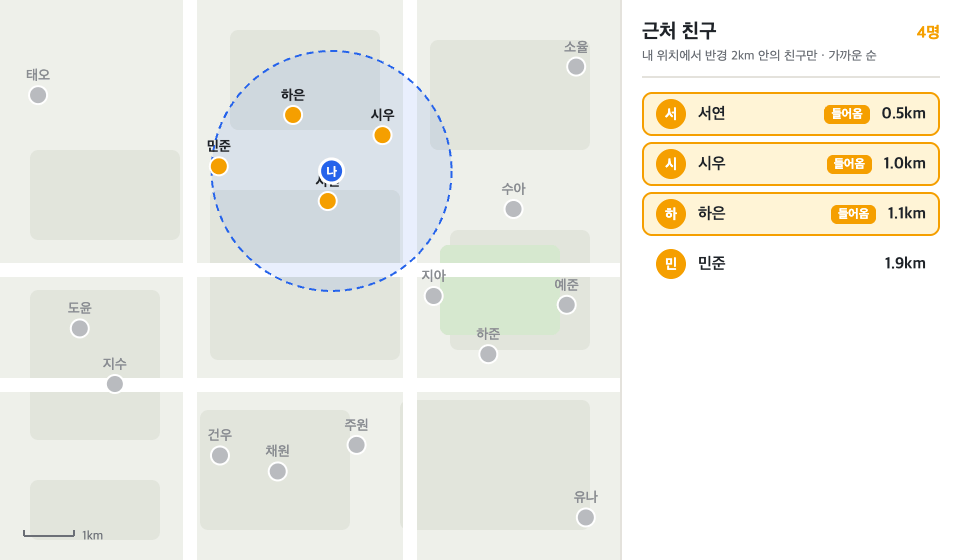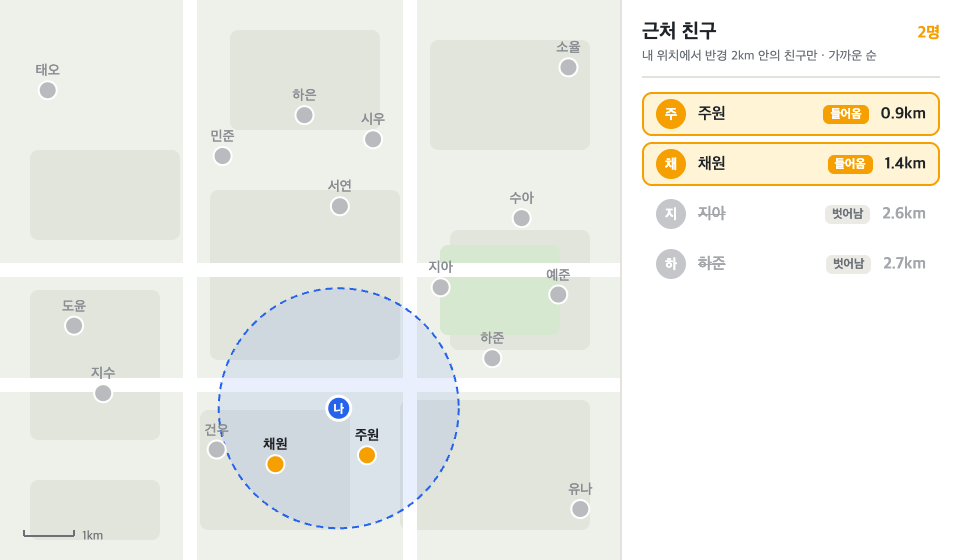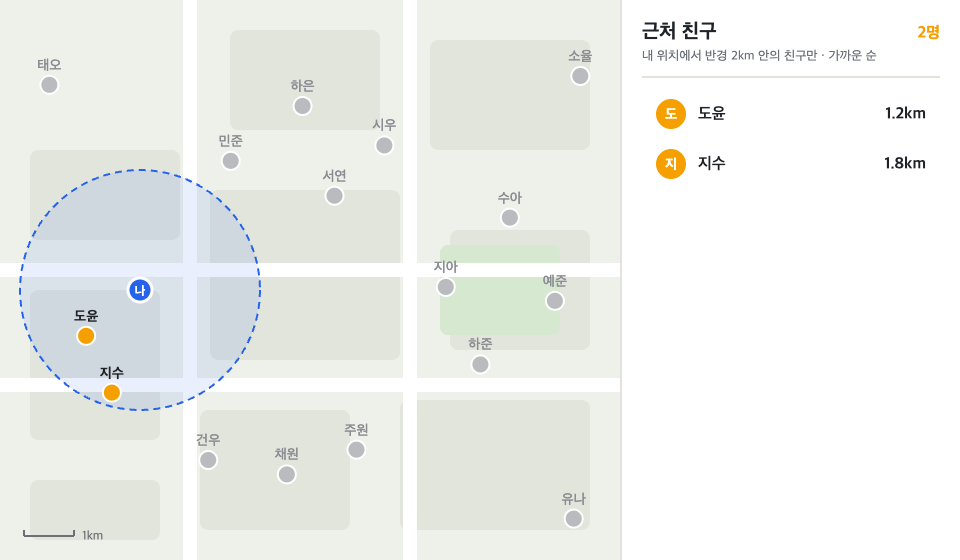
참고
- 알렉스 쉬, 산 란, 『가상 면접 사례로 배우는 대규모 시스템 설계 기초 2』, 인사이트 — 2장 주변 친구